Ich wollte wissen, ob meine RTX 4070 aus einer Anime-Gitarristin ein kleines Musikvideo machen kann. Inzwischen habe ich mehrere Videomodelle ausprobiert, zwölf Bühnenbilder vorbereitet, über Gitarrenhände diskutiert und meinem Rechner erklärt, dass ein Konzert kein Grund für eine vollständige Arbeitsverweigerung ist.
Der ursprüngliche Plan war wirklich überschaubar: ein Bild, ein bisschen Bewegung, vielleicht Gesang. Mal schauen, was heute lokal so geht.
Also genau die Sorte Satz, bei der erfahrene Gedankenbrei-Leser vorsorglich das Wochenende aus dem Kalender streichen.
Einige Modell-Downloads später gab es tatsächlich Videos. Und ich saß davor mit diesem ganz besonderen Gesichtsausdruck zwischen „Schon beeindruckend“ und „Warum streichelt diese Frau ihre Gitarre?“
Das hier ist mein bisheriger Bastelbericht. Mit beiden 30-Sekunden-Fassungen, den Bildassets, Messwerten und einem ComfyUI-Paket zum Nachbauen. Mit Erfolgen, aber auch mit Ergebnissen, die meinen inneren Musikvideoproduzenten noch nicht von der Couch geholt haben.
Meine Filmproduktion besteht aus einer 4070 und fragwürdiger Zuversicht
Auf meinem Schreibtisch steht keine Renderfarm. Es ist mein normaler Linux-Rechner:
- NVIDIA GeForce RTX 4070 mit 12 GB VRAM
- AMD Ryzen 7 3700X, acht Kerne und 16 Threads
- 32 GB Arbeitsspeicher
- Kubuntu-/Plasma-Desktop auf Ubuntu-26.04-Basis und NVMe-Speicher
Für viele Dinge eine prima Maschine. Bei großen Videomodellen wird aus „zwölf Gigabyte“ allerdings erstaunlich schnell ein philosophisches Gespräch darüber, was man unter „ausreichend“ versteht.
Denn auf der Grafikkarte wohnen nicht nur Modellgewichte. Dazu kommen Zwischenergebnisse, Bild- und Audiodaten, Decoder und der Desktop, der unverschämterweise weiterhin dargestellt werden möchte.
Man kann Modelle kleiner speichern und berechnen lassen. Man kann Teile zwischen Grafikkarte, Arbeitsspeicher und SSD verschieben. Man kann Auflösung, Bildzahl und Rechenschritte reduzieren. Nur verwandelt sich dadurch meine 4070 nicht heimlich in eine größere Karte. Irgendwo bezahlt man: mit Zeit, Speicherverkehr, Einschränkungen oder möglicherweise Qualität.
Meine erste wichtige Erkenntnis lautete deshalb:
„Läuft auf zwölf Gigabyte“ ist eine ziemlich unvollständige Antwort auf die Frage, ob ich damit ein brauchbares Musikvideo hinbekomme.
Was mit dieser Hardware überhaupt realistisch ist
Für diesen Artikel habe ich die aktuellen Projektunterlagen und Modellkarten durchgesehen. Stand: 8. November 2026. Die folgende Übersicht trennt bewusst meine erfolgreichen lokalen Läufe von Herstellerangaben und noch ungetesteten Kandidaten.
| Modell / Verfahren | Einordnung für meine 4070 | Was davon wirklich erprobt ist |
|---|---|---|
| Wan 2.2 TI2V 5B | ComfyUI nennt 8 GB mit nativem Offloading. Ein vergleichsweise zugänglicher Einstieg. | Mein früher Einstieg lief, überzeugte mich optisch aber nicht. ComfyUI-Dokumentation |
| Wan 2.2 I2V A14B, FP8 | Große High-/Low-Noise-Modelle, die in meinem Aufbau nur mit Auslagerung vernünftig handhabbar waren. | Auf genau diesem Rechner für alle sechs Filmszenen genutzt. Das ist mein Praxisbeleg, keine pauschale 12-GB-Zusage für jede Auflösung. Modell- und FLF-Workflows |
| HunyuanVideo 13B über FramePack | Das FramePack-Projekt nennt mindestens 6 GB und unterstützt RTX-40-Karten. Das Verfahren reduziert den Speicherbedarf für Videosequenzen. | Mein FP8-Aufbau lief. Dabei gefiel mir die Bildkonsistenz besser als der Bewegungsumfang. FramePack-Anforderungen |
| LTX-2.5 22B Distilled, W4A8 ConvRot | Ein gezielt quantisierter ComfyUI-Weg. Ein Entwickler dokumentiert eine kleine I2V-Baseline auf einer RTX 4060 Laptop mit 8 GB. | Mein eigener kurzer Lauf auf 12 GB funktionierte ebenfalls. Die spezielle Baseline ist keine Freigabe sämtlicher LTX-Funktionen. Dokumentierter 8-GB-Versuch |
| HunyuanVideo 1.5 | Die offizielle Referenz nennt mindestens 14 GB selbst mit Offloading. Für meine Karte braucht es also einen anderen, zusätzlich optimierten Weg. | Hier nicht getestet. Insbesondere nicht mit meinem älteren FramePack-Aufbau verwechseln. Offizielle Anforderungen |
| CogVideoX-5B | Die Modellkarte nennt für stark speicheroptimierte Diffusers-Konfigurationen deutlich weniger als 12 GB. | Ein weiterer älterer Kandidat, hier nicht installiert oder vermessen. Die genannten Mindestwerte sind keine ComfyUI- oder Geschwindigkeitsgarantie. Modellkarte |
Gerade LTX zeigt, warum man bei solchen Listen genau hinsehen muss: Das offizielle LTX-Desktop-Projekt führt für Linux derzeit 24 GB VRAM, empfohlen 32 GB als Anforderungen auf. Es beschreibt zwar auch niedrigere Zulassungsschwellen, aber daraus wird noch keine Empfehlung für meine Linux-4070. Mein kleiner ComfyUI-Lauf mit Community-Quantisierung ist ein anderer Aufbau. Beide Aussagen können gleichzeitig stimmen. Quelle: LTX Desktop
LTX-2.5 bietet außerdem Audio-/Video-Verfahren, während mein erster Vergleich nur das stumme Bildresultat bewertete. Ich habe damit weder die Audiofähigkeiten noch das ganze Modell ausgetestet. Quelle: offizielles LTX-Repository
Realistisch sind für mich zunächst kurze, vorbereitete Einstellungen mit überschaubarer Auflösung und anschließender Montage. Ein hübscher kurzer Clip ist möglich. Ein frei dirigierbares Anime-Konzert mit korrektem Gitarrenspiel, perfektem Gesang und dauerhaft identischer Figur ist durch die bloße Modellinstallation noch lange nicht bestellt.
Meine Grafikkarte kann rechnen. Für „Bitte einmal komplette Bandprobe verstehen“ fehlt ihr offenbar noch die entsprechende Gewerbeanmeldung.
Der erste Belastungstest hieß: Rechner eingefroren
Bevor ich überhaupt sinnvoll vergleichen konnte, blieb der Rechner bei einem frühen WanGP-/Showrunner-Anlauf hängen. Ein ziemlich eindrucksvoller Stillstand. Nur leider vom falschen Teil der Produktion.
Die exakte Ursache dieses Einfrierens habe ich nachträglich nicht zweifelsfrei bewiesen. Der Speicherhaushalt war danach trotzdem kein Thema mehr, das ich mit „Wird schon passen“ behandeln wollte.
Für die folgenden ComfyUI-Läufe gab es deshalb einen begrenzten systemd-Benutzerdienst: 20 GiB als weiche RAM-Schwelle, 22 GiB als harte Grenze und keinen Swap für diesen Dienst. Dazu reservierte ich 1,5 GB VRAM, nutzte datenträgergestütztes Laden und verzichtete in diesem Startprofil auf gepinnten Arbeitsspeicher.
Ein zusätzlicher Wächter kontrollierte den freien Host-RAM und sollte den jeweiligen Renderdienst stoppen, sobald weniger als 5 GiB verfügbar waren. Immer nur eine Generierung gleichzeitig. Beim späteren Lipsync wurde ComfyUI pausiert, damit WanGP die GPU alleine nutzen konnte.
Das macht einen Rechner nicht unkaputtbar. Es gibt dem Experiment aber einen vernünftigeren Rahmen als meine ursprüngliche Strategie: auf „Start“ drücken und hoffen, dass der Desktop noch einen Abschiedsbrief hinterlässt.
Drei Modelle betreten eine violette Bühne
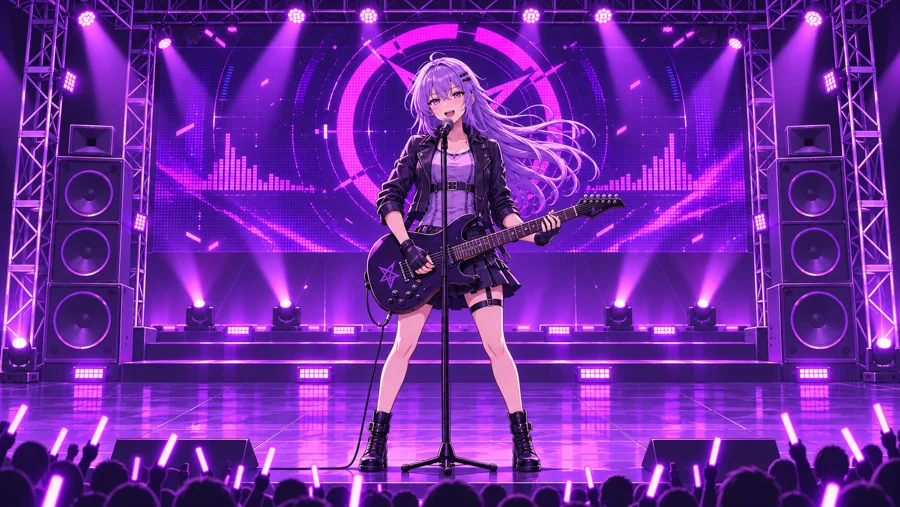
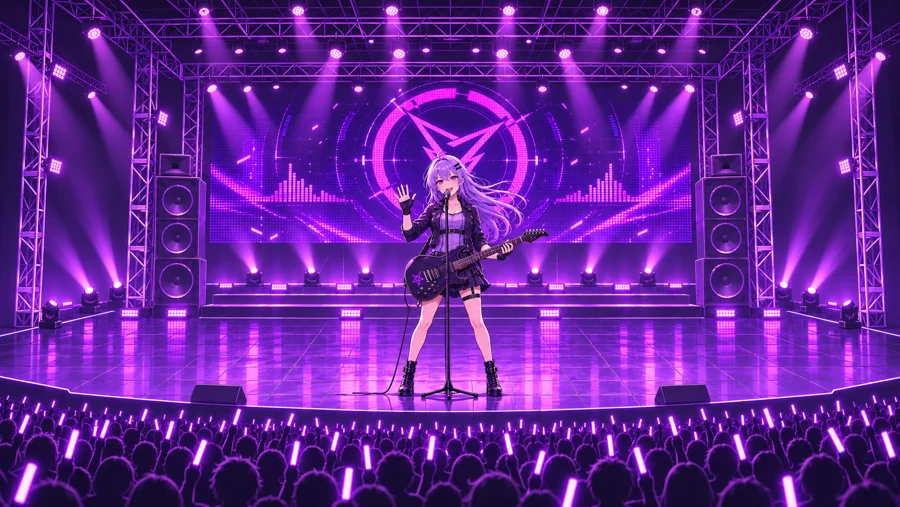
Meine Hauptfigur war vorgegeben: lange lavendelfarbene Haare, schwarze Jacke, Gitarre, Mikrofon und eine Bühne, bei der offenbar jemand die Farbe Violett im Großhandel gekauft hatte.
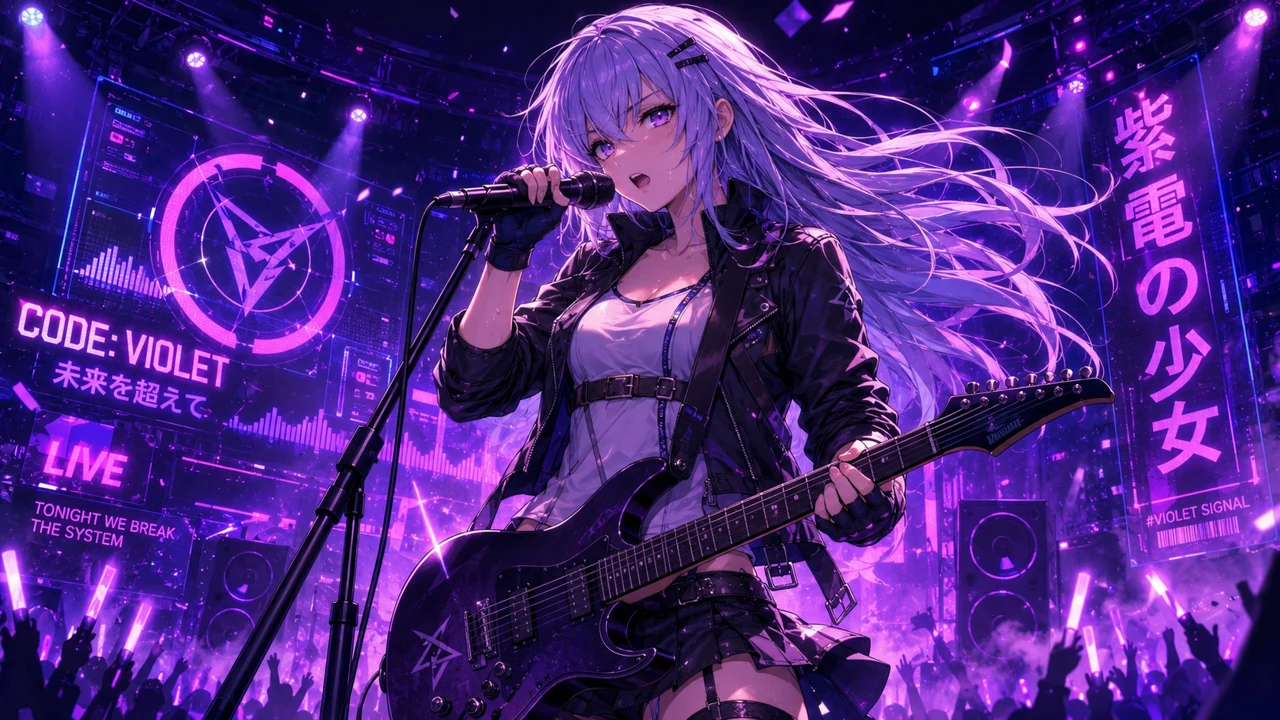
Ich ließ zunächst Wan, LTX und Hunyuan über FramePack kurze Interpretationen derselben Figur und einer zurückhaltenden Bewegungsbeschreibung erzeugen.
| Erster Vergleich | Tatsächliche Ausgabe | Protokollierte Laufzeit |
|---|---|---|
| Wan 2.2 A14B FP8 | 640 × 352, 49 Frames, 16 fps, 3,06 s | 4 min 20 s |
| Hunyuan / FramePack FP8 | 640 × 352, 97 Frames, 30 fps, 3,23 s | 11 min 29 s |
| LTX-2.5 W4A8 | 512 × 256, 73 Frames, 24 fps, 3,04 s | 48 s |
Das ist kein fairer Modell-Benchmark. Unterschiedliche Auflösungen, Framezahlen, Verfahren und Rechenschritte verhindern eine einfache Rangliste. Die Zeiten stammen aus meinen konkreten Läufen einschließlich der jeweiligen Verarbeitung. Aus „48 Sekunden“ folgt weder „LTX ist grundsätzlich so viel schneller“ noch „LTX ist das beste Modell“.
Mein Eindruck war relativ eindeutig: LTX überzeugte mich bei diesem Motiv am wenigsten. Wan zeigte am meisten Veränderung, flackerte aber zunächst heftig. Hunyuan hielt die Figur am konsistentesten zusammen, wirkte beim ersten Versuch allerdings, als habe es vor allem Haare und ein wenig Mundbewegung zur Arbeitsaufnahme überreden können.
Das sind Beobachtungen zu diesen Clips. Keine abschließenden Urteile über drei ganze Modellfamilien. Ich hatte jeweils einen konkreten Aufbau und kein mehrwöchiges Casting mit zwanzig Seeds pro Kandidat.
Trotzdem wollte ich bei Wan weitermachen. Da war zumindest Bewegung drin. Dummerweise teilweise auch an Stellen, an denen ich lieber ein stabiles Bild gehabt hätte.
Das Flackern hatte eine ausgesprochen technische Pointe
Ein wichtiger Teil des Wan-Problems steckte in meiner zeitlich gekachelten VAE-Decodierung. Der VAE macht aus den internen Bildrepräsentationen die sichtbaren Videoframes. Ich ließ ihn zunächst in kleinen Zeitabschnitten arbeiten.
Mit temporal_size=16 und temporal_overlap=4 zeigten sich starke Sprünge in regelmäßigen Abständen. Also testete ich denselben bereits berechneten Wan-Ausgang noch einmal. Gleiche Latents, gleicher Seed, gleiche Sampler-Einstellungen. Geändert wurde nur die zeitliche Decodierung.
Für den 49-Frame-Clip stellte ich auf temporal_size=64 und Überlappung 8 um. Damit passte der ganze Clip in ein Zeitfenster. Die späteren 81-Frame-Szenen bekamen ein Zeitfenster von 128.
An den auffälligen Übergängen bei Frame 12, 24 und 36 sank meine mittlere Bilddifferenz von rund 12,23 auf 2,54 – etwa 79 Prozent. Das bedeutet 79 Prozent weniger von genau diesen gemessenen periodischen Sprüngen. Es bedeutet ausdrücklich nicht „79 Prozent bessere Filmqualität“.
Die ruhigere rechte Fassung war auch im direkten Vergleich deutlich angenehmer. Ein allgemeiner Deflickerfilter wurde dafür nicht darübergelegt. Die Gitarristin hatte also noch dieselben darstellerischen Probleme, wurde dabei aber wenigstens nicht mehr ständig vom Decoder umdekoriert.
Die unangenehme Erkenntnis: Ein Teil meiner Enttäuschung über „die KI“ war eigentlich Enttäuschung über meinen Aufbau. Mein Urteil hatte sich schon einen Richterhammer besorgt, während der Fehler noch im Verkabelungskeller saß.
Bitte Gitarre spielen. Nein, nicht so. Nein, auch nicht so.
Nachdem das Bild ruhiger war, wollte ich mehr Auftritt: Sie sollte spielen und sichtbar singen.
Wan lieferte Handbewegungen. Leider teilweise mit einer Geschwindigkeit, bei der ich eher an den letzten verfügbaren Parkplatz als an einen entspannten Gitarrenanschlag denken musste.
Also verlangte ich kleinere, langsamere Bewegungen. Zwei deutlich getrennte Anschläge. Natürlichere Handgelenke. Weniger hektisches Herumgerühre.
Die nächste Fassung war tatsächlich ruhiger. Die Hand bewegte sich zur Gitarre – und blieb dann ziemlich zufrieden dort liegen.
Großartig. Aus der übermotivierten Gitarristin war eine fachkundige Instrumentenbesitzerin geworden.
Daran sieht man eine Grenze meines Versuchs sehr gut: Ein Bewegungswunsch im Prompt ist keine präzise Animation. „Spielt Gitarre“ legt nicht automatisch fest, wann welches Handgelenk wie weit kippt, welche Finger welchen Bund greifen und welcher Anschlag zu welchem Ton gehört.
Ich konnte den Gesamteindruck beeinflussen. Exakte Spieltechnik bekam ich damit nicht zuverlässig bestellt.
Dann eben mit Regie: sechs Einstellungen statt einer Wunderbestellung
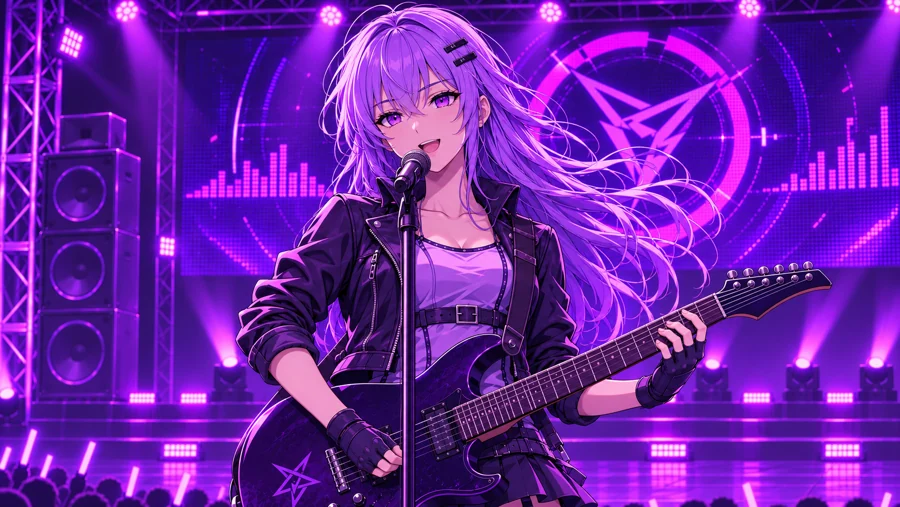
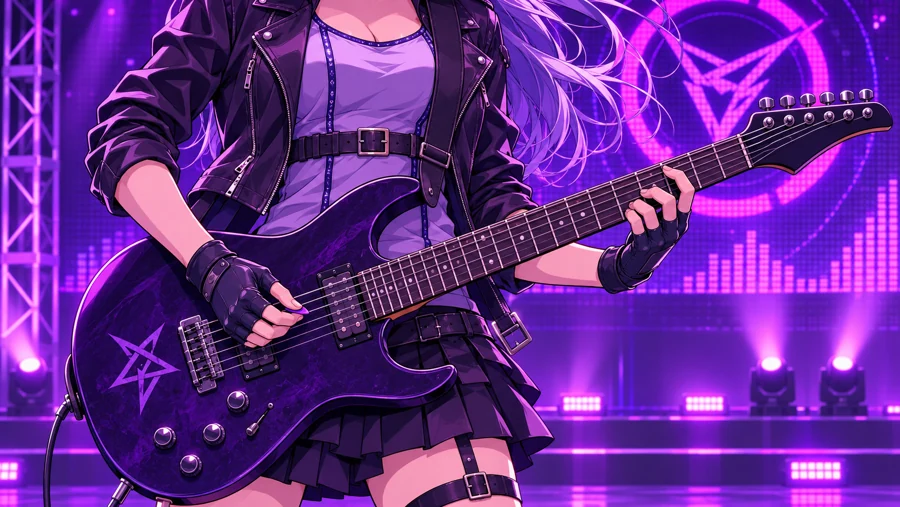
Statt einer einzigen überladenen Szene plante ich ein kleines Konzertvideo: sechs Einstellungen zu je fünf Sekunden. Jeweils ein Anfangs- und ein Endbild, dazu ein überschaubarer Bewegungsauftrag.
Ich übernahm dabei gleichzeitig Regie, Kameraplanung und technische Schadensbegrenzung. Dazu kamen meine ausgesprochen präzisen Produktionsanweisungen: „Da passiert zu wenig“, „Die Hand ist zu schnell“ und „So hatte ich mir das irgendwie nicht vorgestellt“.
Also praktisch schon ein richtiges Filmset.
| Zeit | Geplante Einstellung |
|---|---|
| 00–05 s | Fronttotale, langsame Vorfahrt zur Sängerin |
| 05–10 s | Gesang halbnah, leichte seitliche Kamerabewegung |
| 10–15 s | Gitarrendetail mit beiden Händen |
| 15–20 s | Bewegung am Bühnenrand |
| 20–25 s | Blick über die Schulter ins Publikum |
| 25–30 s | Zurückfahrende Kamera und geplanter Abschlussgruß |
„Geplant“ ist hier ein wichtiges Wort. Auch Anfangs- und Endbilder erzwingen nicht jede gewünschte Zwischenbewegung. Der Schlussgruß und das genaue Gitarrenspiel sind deshalb kein Musterbeispiel vertragstreuer Schauspielerei geworden.
Die zwölf zusätzlichen Bildassets wurden mit dem eingebauten Bildgenerator erstellt. Sie sind keine lokal auf der 4070 erzeugten Bilder. Lokal liefen die folgenden Videoberechnungen und die Audio-Verarbeitung. Das gehört dazu, wenn man ehrlich erzählen möchte, was die eigene Hardware geleistet hat.
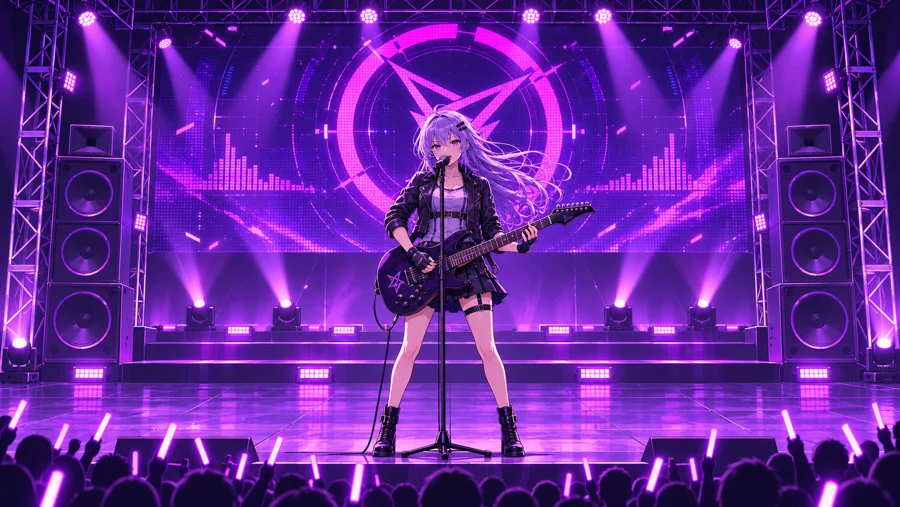
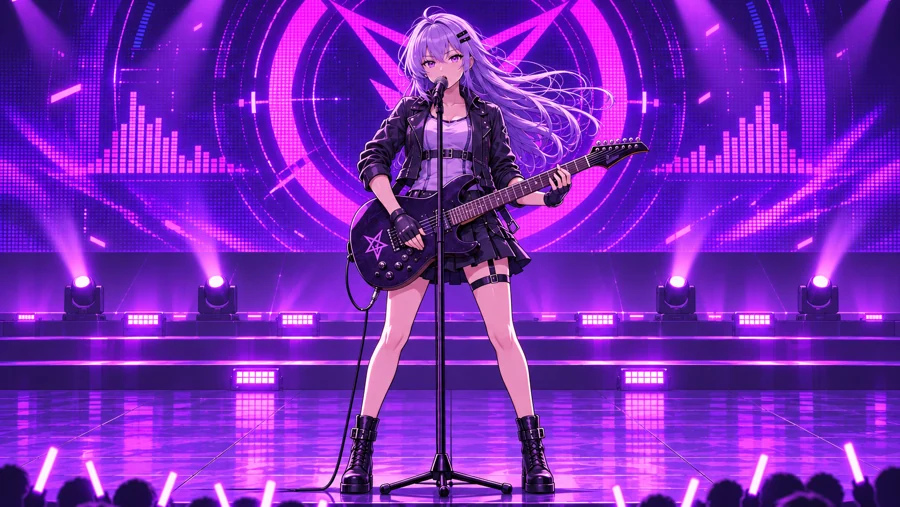
Hier sind sämtliche verwendeten Anfangs- und Endbilder. Die Vorschau zeigt verkleinerte WebP-Kopien; die originalen PNGs stecken im Downloadpaket.
00-05 s · Bühne entdecken
05-10 s · Gesang nah
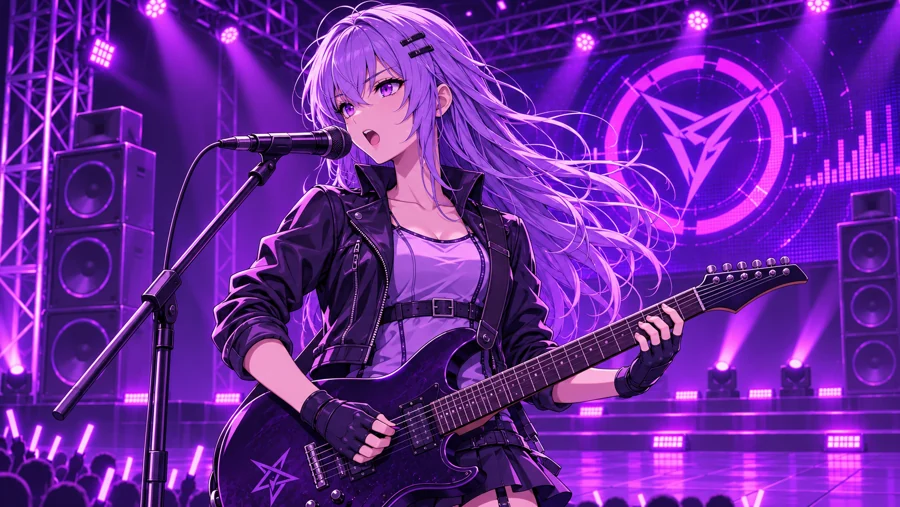
10-15 s · Gitarrendetail
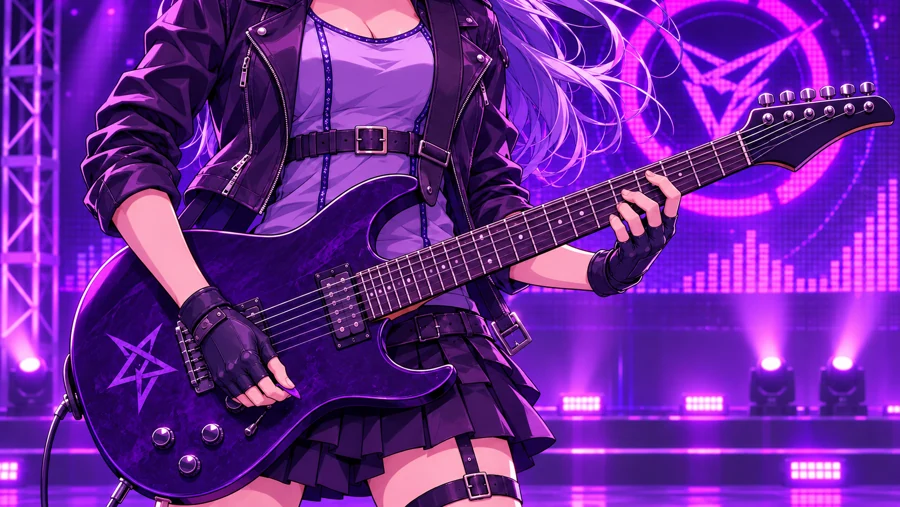
15-20 s · Am Bühnenrand
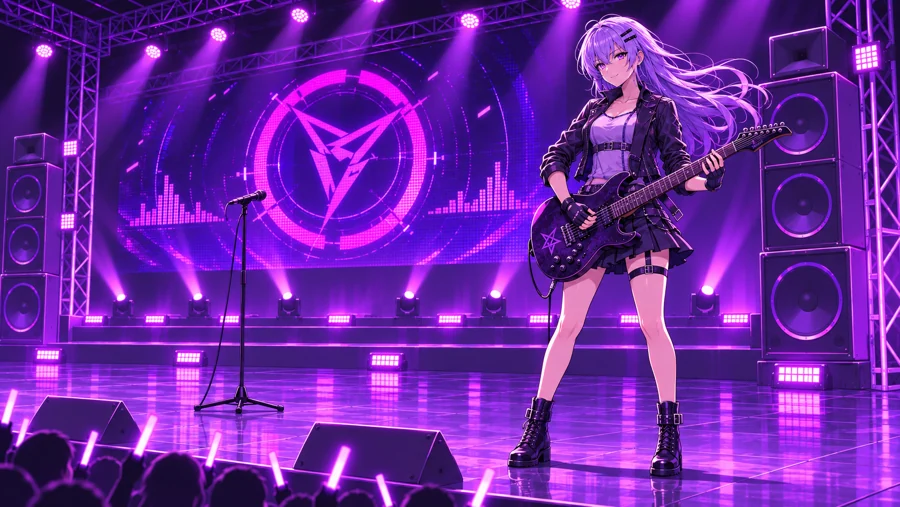
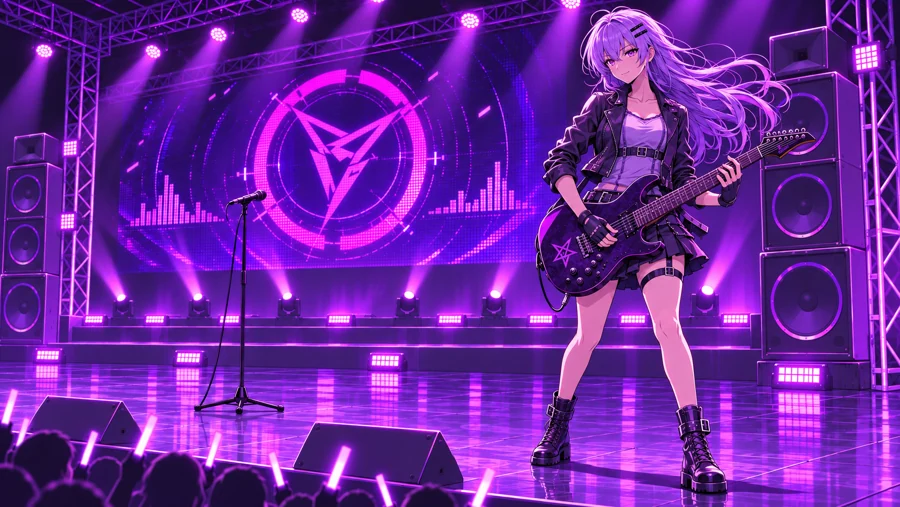
20-25 s · Blick ins Publikum
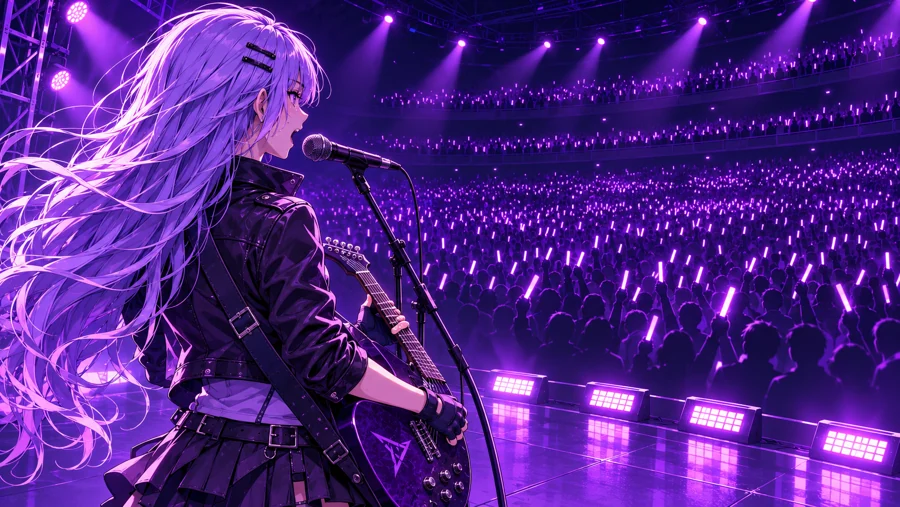
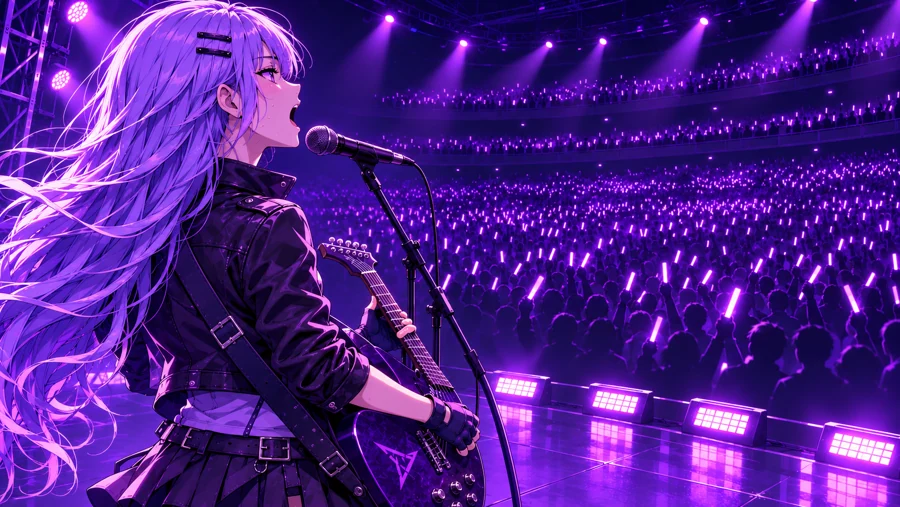
25-30 s · Finale Publikum
So ist der ComfyUI-Aufbau verdrahtet
Im Kern bekommt jede Szene zwei Bildreferenzen und einen Prompt. WanFirstLastFrameToVideo bereitet daraus die Bedingungen für den Videolauf vor. Anschließend arbeiten die High- und Low-Noise-Modelle von Wan 2.2 A14B nacheinander. Danach folgen gekachelte VAE-Decodierung und Videoausgabe.
Mein konkreter Filmsatz: 640 × 352 Pixel, 81 Bilder bei 16 fps, insgesamt 20 Sampler-Schritte, CFG 3,5, Euler/simple und Shift 5. Die Decoder-Kacheln waren räumlich 256 Pixel groß, mit 64 Pixeln Überlappung; zeitlich nutzte ich 128 mit Überlappung 8. Für die sechs Bildszenen waren keine zusätzlichen ComfyUI-Custom-Nodes erforderlich.
81 Bilder bei 16 fps ergeben zunächst 5,0625 Sekunden. Für den Schnitt wurden sie sanft auf fünf Sekunden verteilt. Der fertige Export hat 30 fps. Dabei entsteht keine neue echte Bewegungsinformation: Die höhere Ausgabebildrate macht aus meinen 16-fps-Generierungen keine neu animierten 30 fps.
Das ist übrigens auch der Grund, warum ich hier kein „4K“ auf das Etikett klebe. Man kann kleine Bilder größer speichern. Das verleiht einer problematischen Gitarrenhand aber keine nachträgliche musikalische Ausbildung.
Fassung eins: dreißig Sekunden Bühne, noch ohne Musik
Das ist der erste vollständige Bildschnitt. Er hat absichtlich keinen Ton und noch keinen audiogesteuerten Lipsync. Die vorhandenen Mundbewegungen stammen aus den normalen Videoprompts.
Für sich betrachtet finde ich Teile davon durchaus hübsch. Die Figur bleibt oft erkennbar, die violette Bühne trägt den Look und die Perspektivwechsel helfen. Gleichzeitig sieht man ziemlich schnell, wo eine echte Performance fehlen würde: bei den Händen, der zielgerichteten Bewegung und den kleinen Details, die über einen glaubwürdigen Auftritt entscheiden.
Fassung zwei: jetzt mit „After the Ashes“ und Lipsync
Danach kam die MP3 dazu: After the Ashes. Ich suchte aus dem knapp vierminütigen Stück einen passenden 30-Sekunden-Ausschnitt aus: 2:20,22 bis 2:50,22.
Die Auswahl stützte sich auf lokale Transkription, Gesangsverlauf und Beat-Erkennung. Anschließend trennte ich den Gesang vom restlichen Mix. Diese isolierte Stimme sollte die Mundanimation steuern. Im fertigen Film hört man dagegen den Original-Stereomix des Ausschnitts.
Wichtig: Ein Prompt wie „Sie singt“ ist noch keine Synchronisation mit einer bestimmten MP3. Dafür nutzte ich einen weiteren Modellschritt: InfiniteTalk als Video-to-Video-Verarbeitung in WanGP. Die Bildszenen kamen aus ComfyUI, der Lipsync-Nachgang lief außerhalb von ComfyUI. InfiniteTalk verwendet hier ein Wan-2.1-I2V-Basismodell und zusätzliche Audiokonditionierung. Quelle: InfiniteTalk
Zuerst entstand ein echter Fünfsekunden-Test der Gesangsaufnahme. Erst danach folgte der Rest. Die Gitarren-Nahaufnahme ohne Gesicht blieb unverändert; die übrigen fünf Einstellungen bekamen den Audiomodell-Durchgang.
In der Nahaufnahme ist die veränderte Mundanimation am deutlichsten. Am Bühnenrand bleibt sie dagegen ziemlich zurückhaltend. In den Totalen wird das Gesicht außerdem so klein, dass präzise Lippenformen ohnehin schwer zu beurteilen sind.
Mein zusätzlicher Timing-Check verglich Mundöffnung mit der Energie der isolierten Stimme. Der Testclip schnitt nach der Verarbeitung besser ab. Das ist ein hilfreicher Hinweis, aber kein Nachweis korrekter Mundstellungen für jede Silbe. Eine Figur kann passend den Mund öffnen und trotzdem nicht überzeugend genau diesen Text singen.
Oder anders gesagt: Nur weil ich im richtigen Moment den Mund aufmache, gewinne ich auch noch keinen Gesangswettbewerb. Erstaunlich ungerechtes System.
Wie viel Rechnerzeit steckt in diesen dreißig Sekunden?
Die sechs Wan-Bildszenen brauchten jeweils ungefähr acht Minuten und zwanzig Sekunden. Zusammen waren es 50 Minuten und 27 Sekunden für rund 30 Sekunden Bildmaterial.
Der erste Lipsync-Test schlug im protokollierten Job mit 18 Minuten und 55 Sekunden für fünf Sekunden Video zu Buche. Das ist die gemessene Job-Laufzeit dieses Versuchs, kein sauber isolierter GPU-Kernel-Benchmark.
Für die restlichen Gesangsshots nutzte ich eine FusionX-Beschleunigungs-LoRA und andere Guidance-Werte. Diese vier Durchgänge lagen jeweils bei etwa 4 Minuten 42 Sekunden bis 4 Minuten 57 Sekunden. Auch hier gilt: anderer Aufbau, also keine wissenschaftliche Aussage „acht Schritte sind exakt soundsoviel schneller“. Das Projekt selbst weist bei FusionX auf mögliche Farb- und Identitätsveränderungen hin. Quelle: InfiniteTalk-Hinweise
Die erfolgreichen sechs Bildläufe und fünf Lipsync-Jobs ergeben zusammen rund 89 Minuten protokollierte Rechenzeit. Recherche, Bildassets, Downloads, Audio-Aufbereitung, Schnitt, Tests und Fehlversuche sind darin nicht vollständig enthalten.
Ich wollte kurz etwas ausprobieren. Meine Grafikkarte hatte inzwischen vermutlich einen Betriebsrat gegründet.
Warum mich das Ergebnis trotzdem noch nicht richtig glücklich macht
Die kurze Antwort: Ich sehe ein hübsches Motiv, das sich stellenweise bewegt. Ich sehe aber noch nicht durchgehend einen überzeugenden Konzertauftritt.
Die Hände wissen nicht zuverlässig, was sie spielen. Anschlag, Fingerkontakt, Griffwechsel und Ton passen nicht präzise zusammen. Meine Prompts steuern eine visuelle Annäherung, keine musikalisch definierte Körperbewegung.
Mehr Bewegung kann neue Fehler einhandeln. Weniger Bewegung hält das Bild oft zusammen, wirkt dafür schnell schläfrig. Ich habe diese Grenze bei den Gitarrenversuchen sehr praktisch gefunden. Leider von beiden Seiten.
Lipsync ist eine eigene Baustelle. Der zusätzliche Audiomodell-Schritt hilft, verändert aber auch das Bild. Bei kleinen gezeichneten Gesichtern ist der Erfolg schwerer zu beurteilen als bei einer großen frontalen Mundpartie. Die bisherigen Tests rechtfertigen keine Behauptung von perfekter Silbengenauigkeit.
Kontinuität bleibt Handarbeit. Ähnliche Kleidung, Haarfarbe und Bühne sind eine gute Grundlage. Sie garantieren noch keine über sechs Einstellungen identische Gitarre, jedes Jackendetail oder exakt dieselbe Bühnengeometrie.
Meine Auflösung ist bescheiden. 640 × 352 reicht für eine kleine Vorschau und zum Lernen. Als groß abgespieltes Musikvideo zeigt es die Grenzen deutlich. Mehr Auflösung würde ich separat testen; dass dieser Aufbau läuft, beweist keine beliebig skalierbare Reserve.
Und schließlich: Meine Fehler sind nicht automatisch die Grenzen aller lokalen Video-KI. Ich habe erste Workflows, einige kleine Testläufe und ein schwieriges Anime-Konzertmotiv. Ich habe nicht jedes Modell optimiert, keinen eigenen Bewegungsadapter trainiert und kein echtes Gitarrenspiel als durchgehende Bewegungsvorgabe benutzt.
Den Versuchsaufbau gibt es zum Mitbasteln
Im Download liegen die sechs ComfyUI-Filmworkflows als bearbeitbare UI-JSONs und als API-Graphen, die zwölf Original-Keyframes, Prompts, Modellquellen und eine Anleitung. Dazu kommen meine Messwerte und die Decoder-Diagnose zum Nachlesen.
Die Modellgewichte selbst sind nicht enthalten. Ihr müsst sie aus den verlinkten Quellen beziehen; ihre jeweiligen Bedingungen gelten weiterhin. Ebenso ist das Paket kein fertiger Ein-Klick-Lipsync-Installer: Dieser zweite Teil verwendete meine vorhandene WanGP-Installation. Einstellungen und Ablauf sind dokumentiert, die ComfyUI-JSONs erzeugen zunächst die stummen Bildszenen.
ComfyUI-Versuchsaufbau, Original-Keyframes und Messwerte herunterladen
Zum Einstieg würde ich wirklich nur einen Shot laden, beide Bilddateien kontrollieren und die kleine Auflösung beibehalten. Erst prüfen, dann mehr bestellen. Ein Rat, den ich mir vor diesem Projekt natürlich selbst nicht besonders überzeugend gegeben habe.
Ich bin noch am Anfang. Die Gitarre leider auch.
Ich bin von den bisherigen Ergebnissen etwas enttäuscht. Das darf so dastehen, ohne dass ich das Experiment nachträglich mit Begeisterungslack überziehen.
Gleichzeitig habe ich inzwischen einen nachvollziehbaren Aufbau, zwei vollständige Fassungen, eine deutlich verbesserte Decoder-Einstellung und eine ziemlich konkrete Vorstellung davon, woran es noch hängt. Das ist mehr als ein einzelner zufällig hübscher Clip, den ich anschließend zum Beweis einer technischen Revolution erkläre.
Als Nächstes würde ich die Aufgaben kleiner und überprüfbarer machen: eine frontale Gesangsaufnahme mit größerem Gesicht, einen Gitarrenanschlag mit echter Bewegungsvorlage und eine einzelne kontrollierte Kamerafahrt. Danach lassen sich die funktionierenden Teile wieder zusammensetzen.
Vielleicht auch mit einer einfachen 3D- oder Pose-Vorlage, damit die Maschine wenigstens sieht, was meine Beschreibung von „natürlich spielen“ eigentlich bedeuten sollte. Das wäre ein nächster Versuch, kein bereits getesteter Geheimtrick.
Meine 4070 hat jedenfalls bewiesen, dass sie bei so einem Projekt mitarbeiten kann.
Ob sie damit auch eine glaubwürdige Gitarristin produziert, verhandle ich noch.
Ich würde ihr ja eine Pause gönnen. Aber ich habe da schon wieder so eine kleine Idee. 😅
Quellen, Messwerte und Lesestoff
Die Hardware-Einordnung oben stützt sich auf die direkt verlinkten Projektunterlagen. Messzeiten und Beobachtungen stammen aus meinem Versuch. Den ausführlicheren Recherche- und Faktencheck mit Versionsstand und Belegzuordnung gibt es weiter unten im aufklappbaren Anhang; die maschinenlesbaren Laufdaten liegen auch im Workflow-Paket.
Wer das Muster „kleiner Test, großes Kaninchenloch“ wiedererkannt hat: Mein Serveroberflächen-Ausflug und der WLAN-Schwarzfahrer passen leider ziemlich gut in dieselbe Sammlung fragwürdiger Freizeitplanung.
Ausführliche Recherche und Faktencheck aufklappen
Faktenbasis für den Artikel „Ich wollte nur ein Anime-Musikvideo“. Recherche am 8. November 2026. Offizielle Anforderungen, dokumentierte Community-Aufbauten und meine eigenen Messungen werden getrennt aufgeführt.
Was hier als „läuft“ zählt
Ein Modellname allein beschreibt keinen reproduzierbaren Test. Zu einer brauchbaren Aussage gehören Modellvariante, Zahlenformat, Textencoder, VAE, Auflösung, Zahl der Frames, Schrittzahl und Speicherstrategie. Eine erfolgreiche niedrige Auflösung beweist nicht die Lauffähigkeit größerer Einstellungen. Modell-Dateigröße und notwendiger VRAM sind ebenfalls verschiedene Größen.
Untersucht wurde Inferenz, also das Erzeugen und Bearbeiten von Videos. Die Ergebnisse sind keine Zusage für Modelltraining oder LoRA-Training auf derselben Karte.
1 · Wan 2.2: zwei sehr unterschiedliche Größenklassen
Offizielle ComfyUI-Anleitung · Wan-Projekt
ComfyUI beschreibt TI2V 5B als mit 8 GB und nativem Offloading nutzbar. Die Seite dokumentiert außerdem die getrennten 14B-T2V-, I2V- und First-/Last-Frame-Verfahren. Diese Aussage zu 5B darf nicht auf alle A14B-Workflows übertragen werden.
Eigener Nachweis: A14B-I2V-FP8, zwei Experten-Dateien, UMT5-FP8 und Wan-2.1-VAE liefen auf meiner 4070 in den sechs dokumentierten Szenen. Ich verwendete 640 × 352, 81 Frames, 16 fps, 20 Schritte und datenträgergestütztes Auslagern. Daraus folgt keine allgemeine Speicher- oder Laufzeitgarantie.
2 · FramePack ist ein Verfahren, nicht „das aktuelle Hunyuan“
Offizielles FramePack-Repository · Verwendeter ComfyUI-Wrapper
Das FramePack-Projekt unterstützt RTX-30-/40-/50-Karten und nennt 6 GB als VRAM-Minimum. Diese Herstellerangabe beschreibt den dortigen speicheroptimierten Aufbau. Die beeindruckende mögliche Sequenzlänge ist keine Aussage über flotte Erzeugung auf einer 4070.
Eigener Nachweis: Mein HunyuanVideo-13B-FramePack-FP8-Aufbau erzeugte 97 Bilder mit 640 × 352 bei 30 fps. Er zeigte in den ersten Clips hohe visuelle Ruhe, aber wenig gewünschte Bewegung. Das ist weder ein Test von HunyuanVideo 1.5 noch ein allgemeiner Beweis geringer Bewegungsfähigkeit.
3 · HunyuanVideo 1.5: Referenzanforderung über meiner Karte
Offizielle Systemanforderungen
Das Referenzprojekt nennt 14 GB Mindest-VRAM mit aktiviertem Offloading. Meine 12-GB-Karte unterschreitet diesen Wert. Andere Implementierungen, Quantisierungen und aggressiveres Auslagern können abweichende Anforderungen haben; eine bloße Modellunterstützung in einem Tool belegt aber noch keinen erfolgreichen Lauf auf meinem Rechner. Hier nicht installiert, nicht vermessen und nicht als getestete Empfehlung dargestellt.
4 · LTX-2.5: Modell, Desktop-App und kleine Quant-Baseline auseinanderhalten
Offizielles Inferenzprojekt · Offizielle Gewichte · Desktop-Anforderungen
Die aktuelle Desktop-Tabelle führt für Linux 24 GB VRAM, empfohlen 32 GB, und 32 GB RAM auf. Der Text unterscheidet davon niedrigere Hardware-Schwellen, die nicht als Empfehlung gelten. Die Desktop-App ist deshalb kein Beleg, dass jede beliebige LTX-Konfiguration mit 12 GB komfortabel läuft.
Das Inferenzprojekt beschreibt unterschiedliche Pipelines, Audio-to-Video und Möglichkeiten zur Quantisierung beziehungsweise CPU-/Disk-Auslagerung. Funktionsumfang und Speicherbedarf hängen vom gewählten Verfahren ab.
Primärbericht eines 8-GB-Workflows · Quelle meiner quantisierten Transformer-/Textencoder-Dateien
Der Baseline-Autor dokumentiert eine RTX 4060 Laptop mit 8 GB VRAM und 16 GB RAM unter Windows. W4A8-Gewichte, dynamisches Auslagern und BF16-VAE sind wesentliche Bestandteile. Sein erster Versuch deaktiviert die finale Audioausgabe. Das dokumentierte Video ist nur 512 × 256 mit 73 Bildern lang. Es handelt sich ausdrücklich nicht um eine Garantie beliebiger Auflösungen und Funktionen.
Eigener Nachweis: Mein daran orientierter, für meinen Speicherhaushalt angepasster ComfyUI-Aufbau erzeugte ein solches kurzes stummes Video auf der 4070. Ich verwendete andere Auslagerungseinstellungen als die Windows-Baseline. Das schwache Resultat bei meiner Anime-Figur erlaubt weder eine allgemeine Abwertung von LTX-2.5 noch eine kausale Schuldzuweisung an die Quantisierung. Dafür fehlen kontrollierte Vergleichsläufe.
5 · CogVideoX-5B: weitere Möglichkeit, kein eigener Test
Die Tabelle nennt für 5B mit speicheroptimierter Diffusers-Inferenz Ausgangswerte von 5 GB BF16 beziehungsweise 4,4 GB INT8. Es sind konfigurierte Mindestfälle, keine Angaben für einen beliebigen ComfyUI-Workflow. Der ältere Ansatz bleibt eine weitere lokale Option, ist aber nicht Teil meines Vergleichs. Herstellerzeiten auf A100 oder H100 werden ausdrücklich nicht auf die 4070 übertragen.
6 · InfiniteTalk: Audiokonditionierung statt bloßer Gesangs-Prompt
Offizielle InfiniteTalk-Anleitung · Verwendete WanGP-Integration
Die dokumentierte Modellkombination enthält Wan2.1-I2V-14B-480P als Basis, Wav2Vec und InfiniteTalk-Audiogewichte. Die Anleitung beschreibt V2V, quantisierte beziehungsweise Low-VRAM-Verfahren und geänderte Guidance-Werte beim LoRA-Einsatz. Sie weist auch auf mögliche Farb- und Identitätseinbußen mit FusionX hin.
Eigener Nachweis: Quantisiertes InfiniteTalk-V2V in der vorhandenen WanGP-Installation. Zuerst ein 5s-Pilot, dann vier weitere 5s-Shots; 640 × 352, 25 fps und 125 Frames. Die isolierten, jeweils zeitlich passenden Gesangsausschnitte dienten als Steuerung. Der fertige Film verwendet den ursprünglichen Musikmix. Dies war kein ComfyUI-Lipsync-Workflow und keine Prüfung nativer Audioerzeugung durch Wan 2.2.
Meine Zahlen: Belege und zulässige Aussage
| Befund | Lokaler Beleg im Download | Interpretation |
|---|---|---|
| Wan 260,087 s; FramePack 689,444 s; LTX 47,925 s | evidence/erster_modellvergleich.json |
Drei konkrete Jobs. Unterschiedliche Auflösung, Bildzahl und Verfahren; kein fairer Geschwindigkeitsvergleich. |
| Periodische Bilddifferenz 12,229 → 2,544 | evidence/decoder_bilddifferenzen.json, evidence/decoder_lauf.json |
Dieselben Wan-Latents, zeitliches VAE-Fenster 16/4 gegen 64/8. Rund 79,2 % weniger Differenz an den zuvor auffälligen Frames 12, 24 und 36. Keine globale Qualitätsnote. |
| Sechs Bildszenen: 3026,58 s | evidence/wan_shot_01.json bis 06 |
50:26,58 Minuten tatsächliche Jobzeiten; durchschnittlich rund 8:24 Minuten pro Szene. |
| Erster Lipsync-Test: 1135,02 s | evidence/lipsync_test.json |
18:55,02 Minuten Jobzeit. Nicht als reine Rechenleistung des Modells isoliert. |
| Weitere Lipsync-Shots: 297,40 / 293,59 / 282,43 / 284,32 s | evidence/lipsync_01_result.json sowie 04, 05, 06 |
Beschleunigte Konfiguration mit LoRA und anderen Guidance-Werten. 19:17,73 Minuten zusammen. Kein kontrollierter Vergleich einer einzigen veränderten Größe. |
| Summe erfolgreicher Filmjobs: 5319,34 s | Summe der genannten sechs + fünf Jobs | ≈ 88:39 Minuten, ohne vollständige Vorarbeiten und Fehlversuche. |
| Musikfilm: 30,000 s, 900 Bilder, H.264 und AAC-Stereo | evidence/musikfassung.json |
Exportdaten und vollständiger Decode wurden geprüft. Das ist keine Garantie visueller oder phonetischer Fehlerfreiheit. |
Die Pilotmessung vergleicht Gesangsenergie mit Mundöffnung aus Gesichtspunkten. Vorher: Korrelation bei Zeitversatz null −0,120, nachher +0,115; die stärkste Korrelation nachher lag bei etwa −0,08 Sekunden. Das ist eine Verbesserung dieses Hilfsmaßes und kein Phonemtest. Die kleine Anime-Mundpartie begrenzt die Aussagekraft zusätzlich.
Reproduzierbarkeit und offene Grenzen
Der beigepackte Aufbau enthält die ursprünglichen API-Parameter und portabel aufbereitete UI-Dateien. Die sechs Bildszenen verwenden native ComfyUI-Nodes. Der ältere FramePack-Vergleich braucht einen zusätzlichen Wrapper. Der Lipsync ist separat dokumentiert und setzt eine passend eingerichtete WanGP-Installation und eigene Audio-/Modellpfade voraus.
Ein eingefrorener früher Anlauf ist als Ereignis belegt; seine exakte technische Ursache wurde nicht abschließend festgestellt. Die später eingesetzten Dienstgrenzen und der Wächter adressieren den Speicherhaushalt, beweisen aber nicht rückwirkend eine bestimmte Crashursache.
Keine Stromkosten geschätzt, kein Energieverbrauch aus einer einzelnen Watt-Anzeige hochgerechnet, keine universelle Maximalauflösung behauptet. Ebenso keine Schlussfolgerung, dass ein stärker quantisiertes Modell zwangsläufig die beobachteten Fehler verursacht hat. Die Versuchszahl reicht dafür nicht.